Mit Agentic Coding zu einem besser skalierenden Redaktionssystem
Beim vollständigen Relaunch von undoom.news hatte ich die Richtung vor Augen, aber noch kein fertiges Bild des Redaktionssystems. Ich wollte Zwischenstände benutzen, ihre Wirkung sehen und daran verstehen, wie der nächste Schritt aussehen sollte. Agentic Coding passte zu dieser Arbeitsweise: Änderungen ließen sich unmittelbar umsetzen und im Zusammenhang ausprobieren. Die Oberfläche, die Artikelprüfung und die Zusammenstellung von Tagesausgaben wurden auf diese Weise schrittweise konkreter. Anschließend begann ich, den entstandenen Code gezielt zu konsolidieren.
Eine Grundlage für die weitere Entwicklung
Zwei Voraussetzungen hatte ich früh festgelegt: die technische Grundlage mit PHP und Python und eine modulare Struktur, in der sich einzelne Aufgaben später verändern und optimieren lassen. PHP übernimmt heute unter anderem die Webzugänge, Python die redaktionelle Verarbeitung; Recherche, Prüfung und Veröffentlichung haben eigene Zuständigkeiten. Diese Aufteilung sollte Spielraum für die weitere Entwicklung schaffen. Wie die Redaktion im Einzelnen bedient werden würde, konnte ich dann an der laufenden Anwendung erarbeiten.
Dazu entstand unter „Devnotes“ eine eigene kleine Website für die Entwicklung. Zum ersten Mal hielt ich einen solchen Plan als zusammenhängende HTML-Dokumentation fest, statt wie gewöhnlich Markdown-Dateien zu verwenden. Architektur, Ideen, offene Entscheidungen und Entwicklungsschritte waren darin übersichtlich miteinander verbunden. Auch diese Dokumentation entwickelte sich iterativ. Sie half mir, den jeweiligen Stand zu überblicken und Schritt für Schritt vorzugehen, während sich das Produkt veränderte.
Die Nutzung zeigt die Engpässe
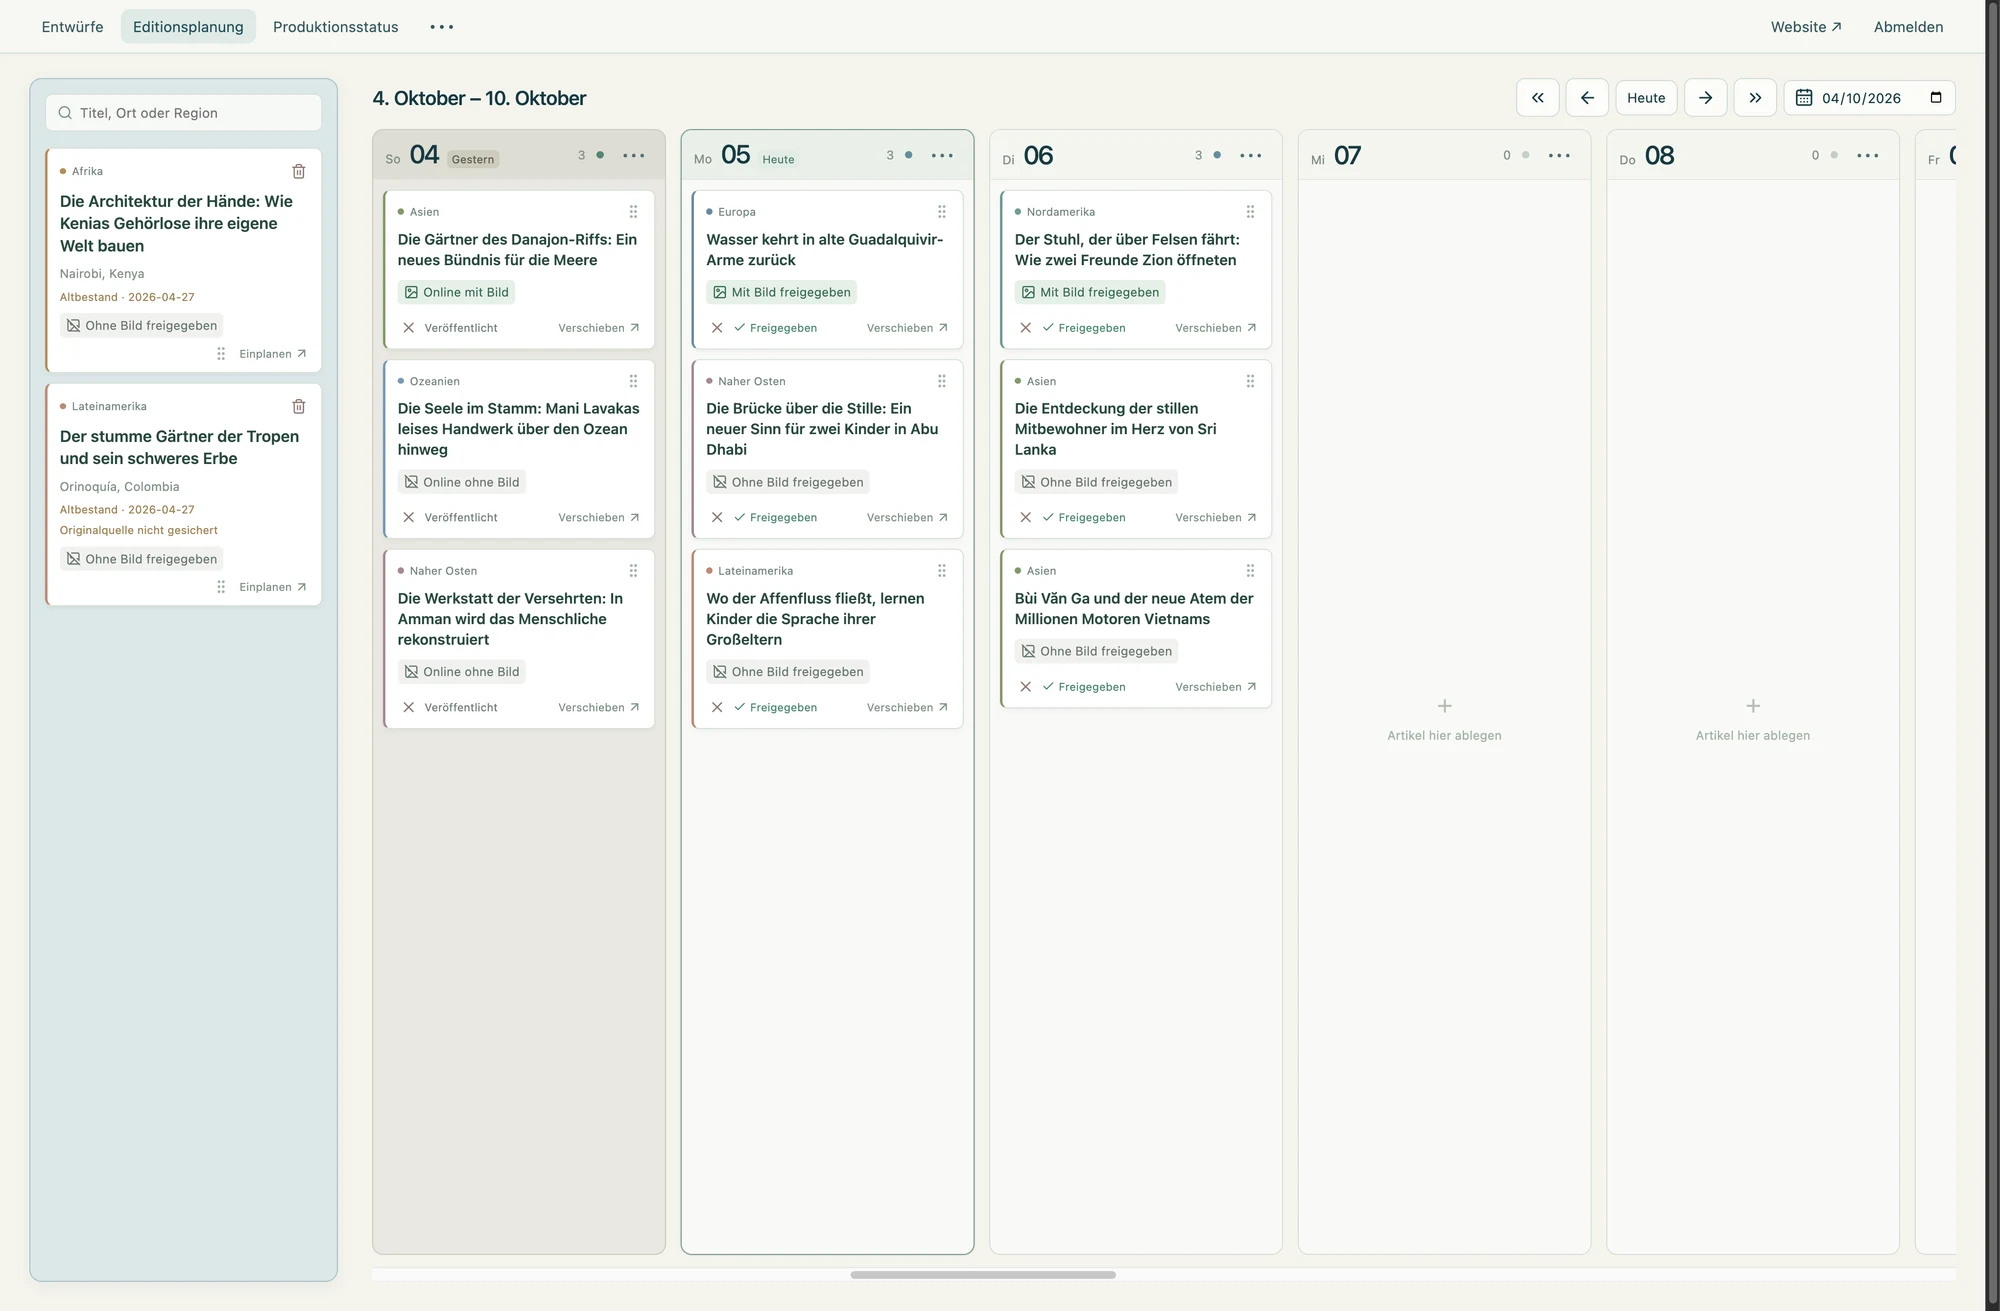
Beim tatsächlichen Arbeiten zeigte sich schließlich ein Problem: Artikel öffneten sich träge, das Einplanen im Kalender dauerte, und selbst eine Freigabe ließ die Oberfläche warten. Schon bei 229 Artikeln war die Verzögerung störend. Ich beschrieb dem Coding-Agenten diese Beobachtungen und verlangte eine Untersuchung der Ursachen. Als sichtbar wurde, wie viel Arbeit hinter einer einfachen Aktion steckte, stellte ich die Umsetzung der Datenzugriffe infrage und beauftragte eine grundlegende Verbesserung.
Ein Abruf des redaktionellen Zustands löste ursprünglich 2.931 Datenbankabfragen aus. Zusätzlich lud die Oberfläche umfangreiche Daten aus früheren Entwicklungswerkzeugen. Nach einzelnen Aktionen wurden große Bestände erneut übertragen, obwohl sich nur eine Karte geändert hatte. Auch die Bildzählung ging für jeden Artikel wieder sämtliche Bilder durch. Die modulare Grundstruktur hatte diese Ineffizienzen nicht verhindert; sie bot jedoch getrennte Bereiche, deren Datenzugriffe wir nun gezielt überarbeiten konnten.
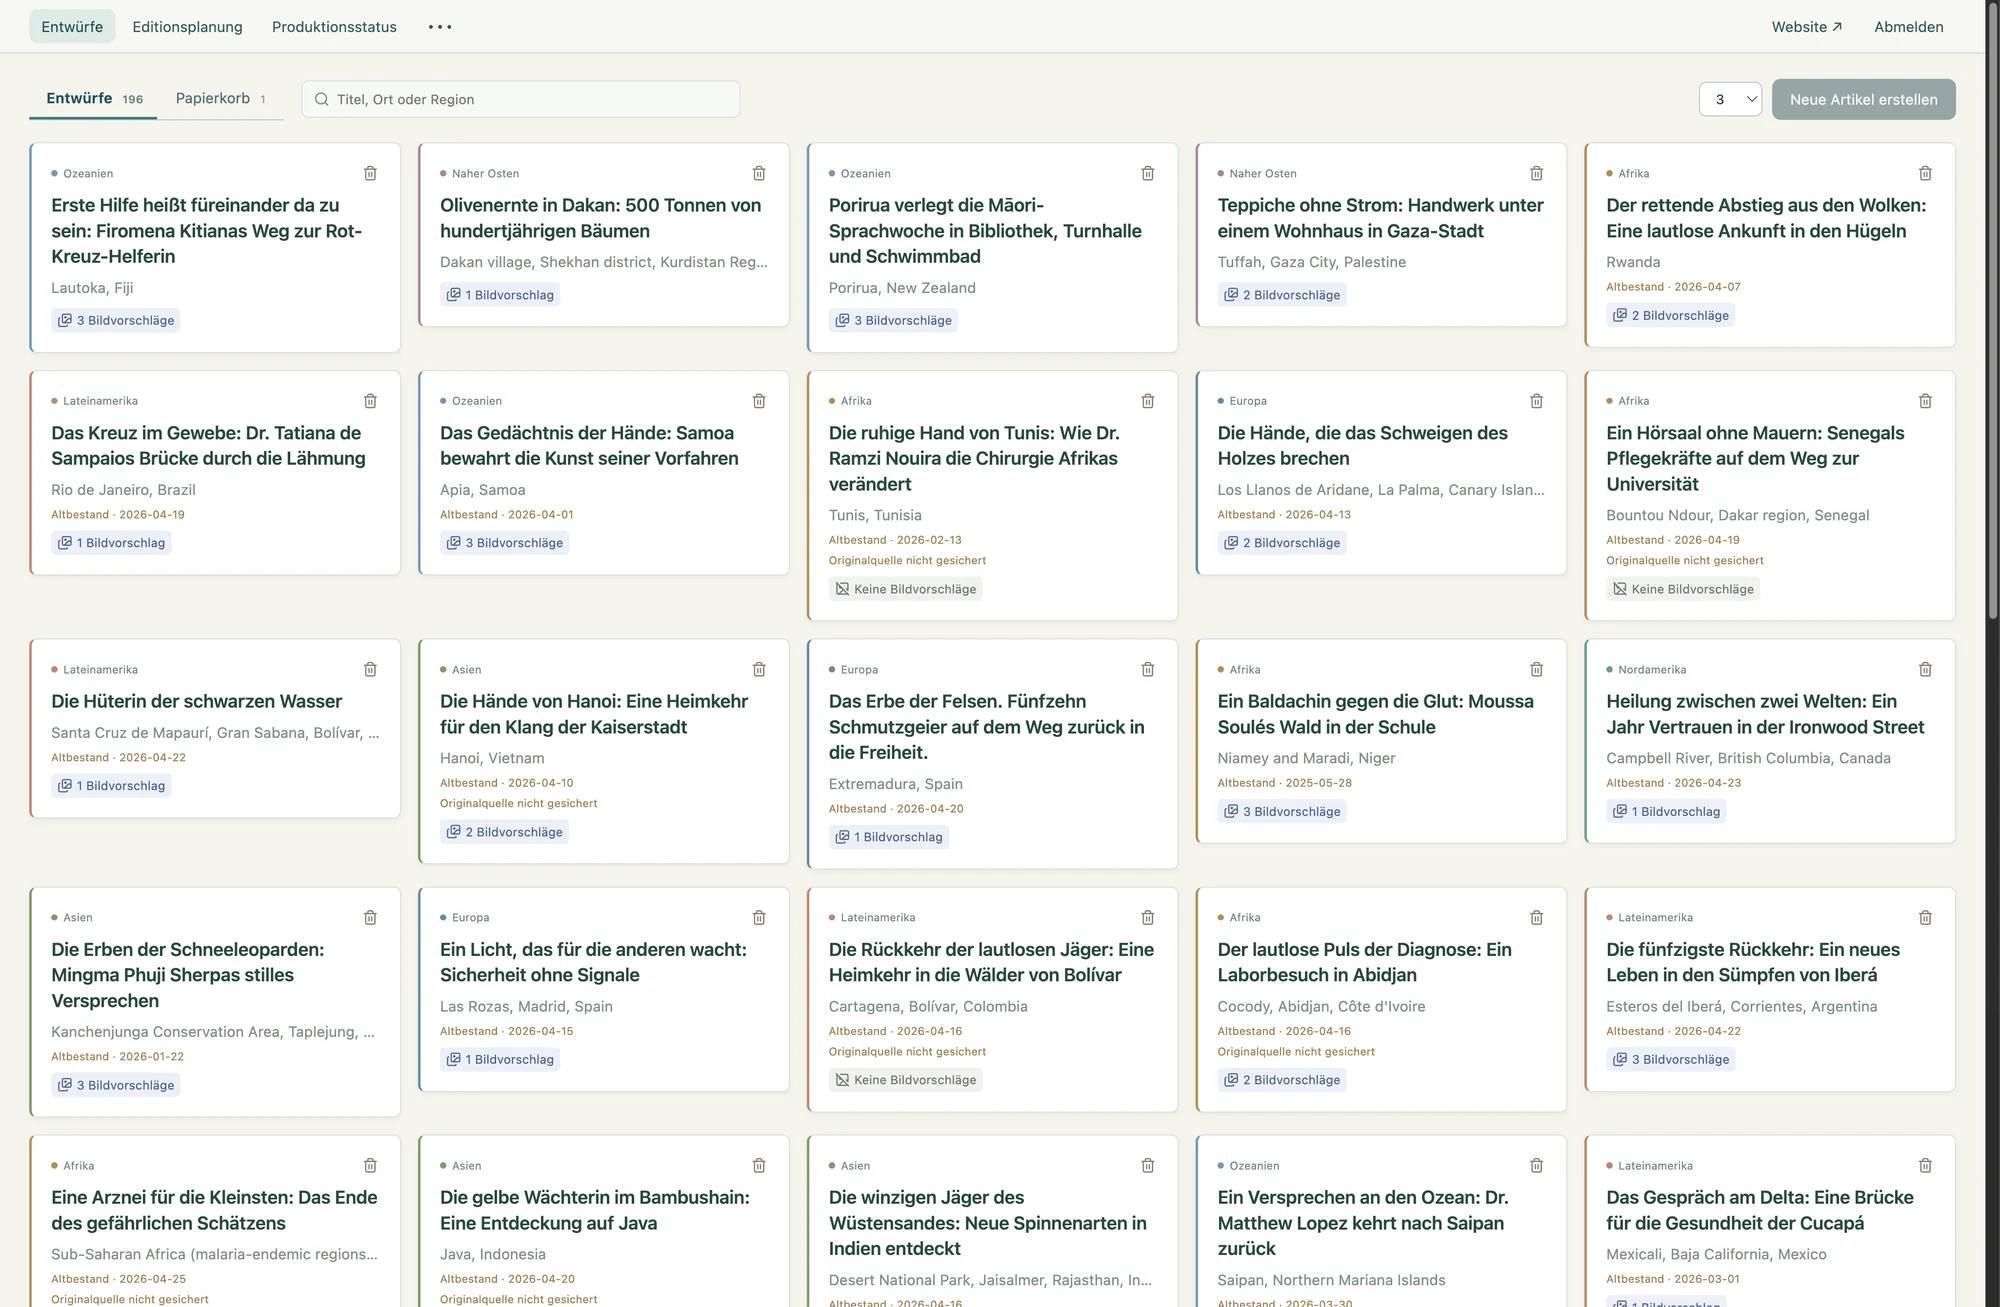
Wir teilten die Lesewege nach ihrem Zweck auf. Die Planung bekommt die Angaben für Karten und Kalender, ein geöffneter Artikel seine Details. Frühere Fassungen werden erst beim Aufklappen geladen. Gemeinsame Daten werden gesammelt abgefragt, Bildvorschläge einmal gruppiert. Ein dauerhaft laufender Backenddienst erspart den Prozessstart bei jeder Anfrage. Die Entwurfsliste lädt jeweils 48 Karten, und Folgeantworten übertragen nur die Änderungen. Die Zahl der Abfragen für die Übersicht sank im Verlauf auf 15. Der optimierte Backendabruf dauerte in den Messungen etwa 0,2 Sekunden; eine unveränderte Folgeantwort umfasste nur 237 Byte.
Indizes anhand der Abfragen prüfen
Anschließend ließ ich die Datenbankindizes gesondert prüfen. Der Agent untersuchte tatsächliche Abfragepläne und fand unter anderem fehlende Statistiken für bereits angelegte Ausdrucksindizes. Wir aktualisierten die Statistiken und ergänzten einen gezielten Index für die Suche nach Bildmetadaten. Eine Detailabfrage blieb dennoch ungünstig: Mehrere mit ODER verknüpfte Suchwege wurden durch getrennte, indexgestützte Abfragen zusammengeführt. In einer Stichprobe sank ihre Laufzeit von rund fünf auf eine Millisekunde. Zusätzliche Indizes für Kalender und Veröffentlichungen stellten wir zurück, weil diese Abfragen beim vorhandenen Bestand bereits wenig Zeit beanspruchten. Die Prüfung lieferte damit auch Gründe, bestimmte Änderungen vorerst nicht vorzunehmen.
Caching mit begrenztem Betriebsaufwand
Erst danach beschäftigten wir uns mit einem dauerhaften Speichercache für den öffentlichen Artikel-Feed. Redis war eine mögliche Lösung, hätte aber einen zusätzlichen Dienst mit eigener Konfiguration und Betriebsaufwand eingeführt. Für den bestehenden PHP-Leseweg entschieden wir uns für APCu auf dem jeweiligen Server. OPcache hält den kompilierten PHP-Code vor; APCu speichert hier die aufbereiteten Antworten je Sprache. Die redaktionellen Schreiboperationen prüfen weiterhin den aktuellen Datenbankzustand.
Für diesen Cache mussten wir festlegen, wann ein gespeichertes Ergebnis seine Gültigkeit verliert. Bei jedem Abruf wird anhand der Veröffentlichungen, fertigen Übersetzungen, Bilddaten und Bildsperren geprüft, ob die gespeicherte Antwort noch zum Datenstand passt. Eine Rücknahme oder Bildsperre wird dadurch beim nächsten Abruf berücksichtigt. Kleine Datenbankabfragen bleiben bewusst erhalten; eingespart werden das wiederholte Laden umfangreicher Inhalte und die Aufbereitung der Antwort. In 30 lokalen Messdurchläufen sank diese reine Feed-Aufbereitung im Mittel von 5,95 auf 0,45 Millisekunden. Das beschreibt einen einzelnen Verarbeitungsschritt, nicht die gesamte Ladezeit im Browser.
Änderungen überprüfen
Zur Konsolidierung gehörte auch eine Regression: Nach einem Umbau meldete das Einplanen einen Fehler, obwohl die Änderung bereits gespeichert war. Die Antwort scheiterte an der Umwandlung eines Datums. Mein Fehlerbericht führte zur Korrektur und zu einem Test des vollständigen Antwortwegs. Bei der Optimierung der Detailabfrage verglich der Agent außerdem die Ergebnisse für sämtliche 229 Artikel, jeweils mit und ohne Historie. Die neue Abfrage musste dieselben Daten in derselben Reihenfolge liefern. Nach der Indexarbeit bestanden 163 Backendtests; beim Cache prüften wir zusätzlich, ob unter anderem Rücknahmen, Übersetzungsänderungen und Bildsperren gespeicherte Antworten zuverlässig ungültig machen.
Meine Aufgabe bestand darin, das Produkt zu benutzen, Reibung zu benennen und technische Entscheidungen weiterzuverfolgen. Der Agent untersuchte den Code, maß auf dem Server, implementierte Änderungen und prüfte ihre Wirkung. Die Arbeit führte von einer konkreten Beobachtung über eine überprüfbare Ursache zu einer begrenzten Änderung. Gerade die Reihenfolge war für mich hilfreich: Die frühen Iterationen machten deutlich, welches System ich tatsächlich brauchte; die anschließende Konsolidierung richtete die Datenzugriffe auf diese Nutzung aus. Die Messungen mit unserem Bestand belegen noch keine Belastbarkeit bei sehr großen Datenmengen. Sie zeigen, welche unnötigen Wiederholungen wir beseitigt haben und wo weitere Infrastruktur bislang keinen ausreichenden Nutzen versprach.